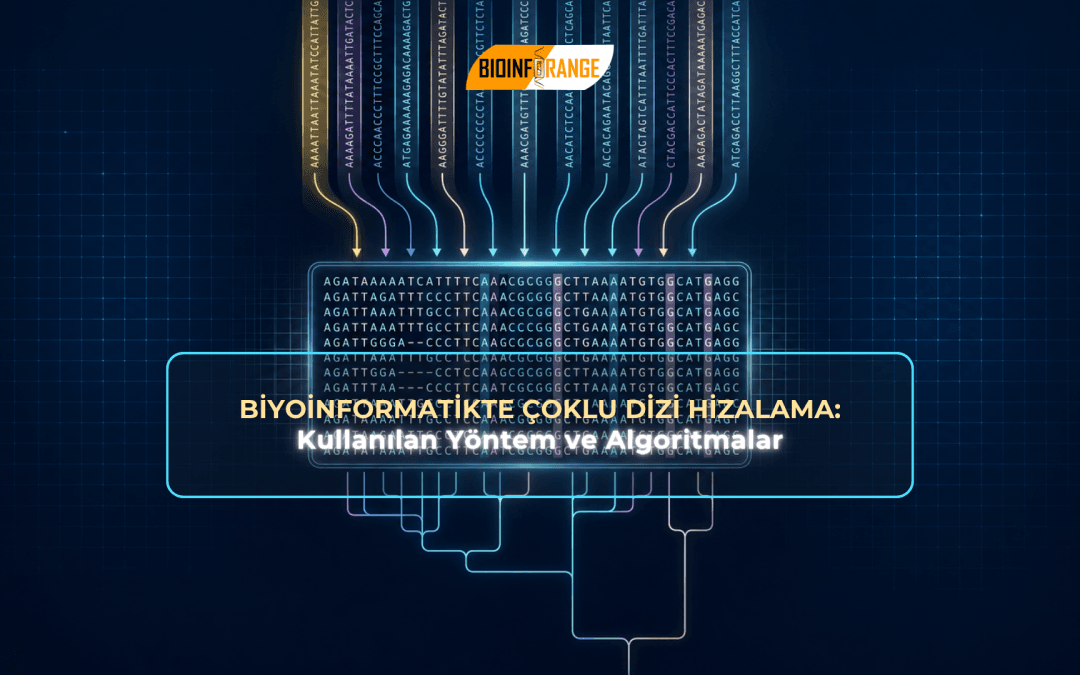
Dizi Hizalama (SA) ve Çoklu Dizi Hizalama (MSA), biyoinformatik dünyasının temel taşlarından biri olarak kabul edilir ve modern biyolojik araştırmalarda hayati bir rol oynar. Bu süreç, moleküler biyolojinin verilerini anlamlandırmak ve canlılar arasındaki evrimsel bağları çözmek için kullanılan en güçlü araçlardan biridir.
Dizi Hizalamanın Tarihsel Yolculuğu
Dizi hizalama çalışmaları, Nobel Ödüllü biyokimyacı Frederick Sanger’in 1950’lerde insülinin protein dizisini belirlemesiyle başlayıp 1977’de kendi adını taşıyan DNA dizileme yöntemini geliştirmesiyle ivme kazandı. Bilgisayar teknolojilerinin gelişimiyle birlikte, 1988’de Des Higgins tarafından geliştirilen CLUSTAL yazılımı bu alanda bir devrim yaratmasının ardından 2002’de Hızlı Fourier Dönüşümü kullanan MAFFT gibi daha hızlı ve etkili araçlar sahneye çıktı.
Temel Kavramlar ve Hizalama Stratejileri
Dizi hizalama, temelde iki ana kategoride incelenir:
- İkili Dizi Hizalama (PSA): Sadece iki dizi arasındaki benzerlikleri ve evrimsel ilişkileri belirlemek için kullanılır.
- Çoklu Dizi Hizalama (MSA): Üç veya daha fazla diziyi aynı anda ele alır. MSA, diziler arasındaki korunan bölgeleri ve fonksiyonel motifleri tanımlayabildiği için PSA’dan daha fazla biyolojik bilgi sunar ve daha avantajlıdır.
Hizalama süreci, dizilerin benzerliğine göre Global (küresel) veya Yerel (lokal) olarak gerçekleştirilebilir. Ayrıca bu süreçte, amino asit değişimlerini evrimsel benzerlik ölçülerine göre değerlendiren PAM ve BLOSUM gibi ikame matrisleri kritik rol oynar.
Çoklu Dizi Hizalamasında Kullanılan Temel Algoritmalar
Karmaşık biyolojik verilerin işlenmesi ve anlamlandırılması sürecinde, farklı matematiksel paradigmalar temel alınmaktadır :
- Dinamik Programlama (DP): Her zaman optimum hizalamayı bulmayı hedefler. Global hizalama için Needleman-Wunsch, yerel hizalama için Smith-Waterman algoritmaları bu kategoridedir; ancak, dizi sayısı arttıkça hesaplama zorluğu (NP-Sıkı problem) nedeniyle büyük veri setlerinde kısıtlıdır.
- Aşamalı Hizalama (Progressive Alignment): Karmaşık problemleri alt problemlere bölen sezgisel bir yaklaşımdır. Önce en benzer diziler hizalanır ve rehber bir ağaç üzerinden diğerleri eklenir. CLUSTALW bu yöntemin en bilinen örneğidir; ancak, ilk aşamada yapılan hataların sonuca yansıması gibi dezavantajları vardır.
- Yinelemeli Hizalama (Iterative Alignment): Aşamalı yöntemin hatalarını gidermek için dizileri tekrar tekrar hizalayarak puanı optimize etmeye çalışır.
- Saklı Markov Modelleri (HMM): Eşleşme, ekleme ve silme durumlarını olasılıksal bir modelle ele alır. Dizileri bir “aile” olarak karakterize etme yeteneği sayesinde oldukça güçlü bir araçtır.
Yazılım Seçimi ve Kalite Tahmini
Bir araştırmacı için en uygun MSA programını seçerken biyolojik doğruluk, çalışma süresi ve bellek kullanımı en önemli kriterlerdir. Literatürde öne çıkan bazı araçlar şunlardır:
- MAFFT ve MUSCLE: Hız ve doğruluk arasında iyi bir denge kurar, orta-büyük veri setleri için uygundur.
- PROBCONS ve T-COFFEE: Çok yüksek doğruluk sunar ancak büyük veri setlerinde (100+ dizi) yüksek hesaplama gücü gerektirir.
- CLUSTALW: Daha az bellek kullanmasına rağmen modern alternatiflerine göre doğruluğu daha düşüktür.
Sonuç
Çoklu dizi hizalama, genetik ve protein dizilerinin karşılaştırılması yoluyla biyolojik çeşitliliği ve evrimsel süreçleri anlamamızı sağlayan vazgeçilmez bir yöntemdir. Veri setlerinin büyüklüğü ve karmaşıklığı analizleri zorlaştırsa da, gelecekte geliştirilecek daha hızlı ve hassas algoritmalar biyolojik bilimlerde yeni keşiflerin kapısını aralayacaktır.
Derleyen: Yüşah TUGAYOĞLU